Jev, Laya o LLM: ridurre costi e latenza dell'IA
Ricerca e chat IA per il vostro sito web.
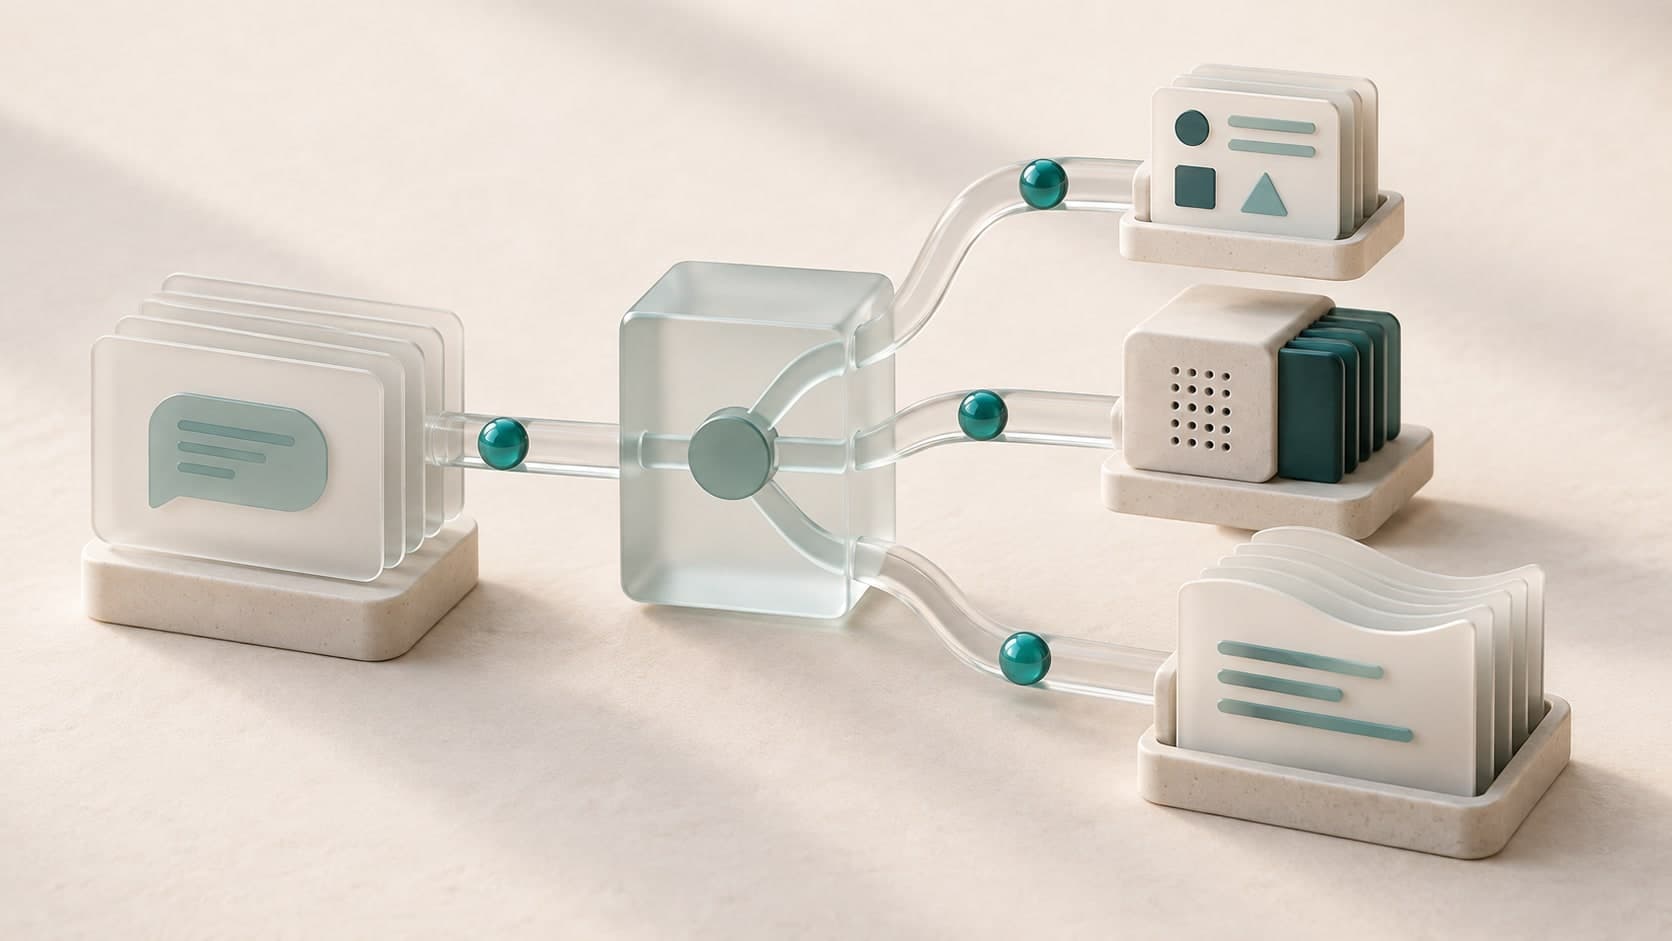
Scoprite AskoliaJev, sviluppato da TypeSafe AI, serve a selezionare, classificare o valutare. Un LLM serve a redigere. Affidare ogni compito al modello adatto può ridurre il costo di un'applicazione IA e velocizzare alcune risposte.
In Askolia, il nostro strumento di ricerca IA e chat per siti web, abbiamo individuato due possibili usi e testato Laya, un'alternativa che può essere ospitata autonomamente.
Quando usare Jev invece di un LLM?
«Quale FAQ risponde a questa domanda?» richiede di selezionare una risposta esistente. «Spiegate questa risposta al cliente» richiede di produrre testo. Questi due compiti possono usare modelli diversi.
Jev restituisce decisioni strutturate: una scelta, un punteggio o una stima sì/no. Non redige risposte.
| Esigenza | Strumento da valutare |
|---|---|
| Selezionare una FAQ o indirizzare una richiesta | Jev, da confrontare con il sistema esistente |
| Classificare documenti utili | Jev o un modello specializzato nel reranking |
| Redigere, tradurre, riformulare | LLM |
| Calcolare un importo, applicare un'autorizzazione | Codice tradizionale |
Anche un LLM può effettuare scelte. Il valore di Jev dipende quindi dal costo, dalla velocità e dall'affidabilità di questa decisione nella vostra applicazione.
Da dove derivano i risparmi?
Il vantaggio deriva dalle chiamate evitate. Se Jev trova una risposta già approvata e disponibile nella lingua giusta, l'applicazione può visualizzarla senza chiedere a un LLM di riscriverla.
Alla tariffa consultata il 23 settembre 2026, 100.000 decisioni Jev con 1.000 token in ingresso costano 4,20 USD. Questo importo copre soltanto l'inferenza.
Esempio fittizio: 100.000 chiamate a un LLM a 0,001 USD costano 100 USD. Se Jev consente di evitarne il 70%, il totale scende a 34,20 USD, comprese le decisioni Jev. Integrazione ed esercizio restano da finanziare.
Se tutte le richieste arrivano poi allo stesso LLM, con lo stesso contesto, Jev aggiunge invece un costo e un passaggio. Su volumi ridotti, il risparmio può anche essere troppo modesto per giustificare l'integrazione.
Lo stesso ragionamento vale per la velocità: misurate il tempo fino alla visualizzazione della risposta. Una selezione rapida aiuta il visitatore solo se riduce davvero la sua attesa.
Askolia: due utilizzi concreti
Selezionare una FAQ senza generare testo
Nel flusso FAQ di Askolia studiato, un LLM sceglie una risposta quando l'abbinamento automatico fallisce. Una seconda chiamata adatta poi il testo alla lingua del visitatore.
La prima possibilità consiste nell'affidare la selezione a Jev. La seconda è riutilizzare le traduzioni già memorizzate. Possono evitare chiamate diverse; i loro guadagni devono essere misurati separatamente.
Quando nessuna FAQ è adatta, il sistema deve proseguire la ricerca o passare la mano. Mostrare rapidamente una risposta sbagliata creerebbe lavoro aggiuntivo per il supporto.
Scegliere meglio le fonti di un RAG
Il RAG cerca documenti prima di chiedere a un LLM di redigere. Jev potrebbe riordinare i passaggi trovati per trasmettergli fonti più pertinenti.
In Askolia, questo passaggio sarebbe un'aggiunta. Il suo primo interesse sarebbe la qualità; un risparmio resta possibile se riduce il testo inviato al LLM o le risposte da correggere.
Per l'integrazione, partiremo dall'SDK TypeScript ufficiale. jev-reranker è un'altra possibilità per sperimentare in Python.
Laya: quando ospitare le decisioni autonomamente?
Laya propone anch'esso scelte e punteggi, con codice aperto e modelli scaricabili. Consente di eseguire queste decisioni sulla propria infrastruttura.
Può interessare un team che vuole controllare dove vengono trattati i propri dati. Occorre tuttavia finanziare la macchina, la sua disponibilità e la manutenzione. A basso volume, un'API può costare meno.
Cosa ci ha insegnato il nostro test di Laya
Su un piccolo insieme di casi sintetici multilingue ispirati ad Askolia, Laya selezionava una FAQ in circa 18 ms di mediana, una volta caricato il modello. Questo tempo locale non misura il tempo completo di una risposta.
Tuttavia, con le impostazioni riprese dal prototipo Jev, il filtraggio bloccava anche domande alle quali una FAQ avrebbe potuto rispondere. Nemmeno la selezione delle fonti documentarie era sufficientemente affidabile.
Non abbiamo quindi scelto Laya come sostituzione diretta con queste impostazioni. Un modello può decidere rapidamente lasciando comunque troppe richieste senza una risposta utile.
Questo test non misura alcun vantaggio rispetto a Jev o all'LLM attuale. I risultati dettagliati e il protocollo restano disponibili per esaminare i limiti del test.
Da dove iniziare nella vostra applicazione?
Scegliete una decisione frequente e precisa: ritrovare una FAQ, indirizzare un ticket, selezionare una fonte. Confrontate le soluzioni sulle vostre richieste, inclusi i casi ambigui e le lingue dei vostri utenti.
Seguite tre risultati: il costo per risposta corretta, il tempo completo e le richieste riprese da una persona. Un prezzo per token più basso non basta se gli errori aumentano.
In Askolia, la selezione delle FAQ è la nostra prima pista per confrontare Jev con il flusso esistente. Il RAG merita un test distinto, incentrato sulla qualità delle fonti.
Per individuare le chiamate evitabili nel vostro prodotto, scoprite il nostro servizio di integrazione dell'intelligenza artificiale o parlateci della vostra applicazione.


 Swiss Made Software

